Our Community is getting an upgrade! To get everything ready for the relaunch, we’ll be placing the site in read-only mode starting September 21st.
We really appreciate your understanding while we get things set up behind the scenes. Catch up on all the exciting details about the move here.
Need help or have questions? Drop us a line at [email protected]

Community Articles

Find and share helpful community-sourced technical articles.
Announcements
Share your experience with Cloudera on G2 and get a $25 Amazon Gift card.
Hi, I'm CLEO! Something exciting is coming to the Community. Stay Tuned!
Labels (2)
avatar
Rising Star

Why not trying a Kaggle Challenge (Titanic) !

(This is a work in progress, I will update this article as soon as I get more free time. Hope you will enjoy it !)

Let's create the corresponding database first :

CREATE DATABASE IF NOT EXISTS kaggle_titanic;

And then load the data :

USE kaggle_titanic;
DROP TABLE IF EXISTS train_tmp;
ADD JAR csv-serde-1.1.2-0.11.0-all.jar;
CREATE TABLE train_tmp (
 PassengerId DOUBLE COMMENT 'regex : 999', 
 Survived DOUBLE COMMENT 'regex : 9', 
 Pclass INT COMMENT 'regex : 9', 
 Name STRING COMMENT 'regex : _Zzz!_Zzzzz_!Zzzzzzzzz_!!Zzzzzz!!_Zzzzzz_Zzzzz!!', 
 Sex STRING COMMENT 'regex : zzzzzz', 
 Age DOUBLE COMMENT 'regex : 99!9', 
 SibSp DOUBLE COMMENT 'regex : 9', 
 Parch DOUBLE COMMENT 'regex : 9', 
 Ticket STRING COMMENT 'regex : ZZZZZ!Z!Z!_9999999', 
 Fare DOUBLE COMMENT 'regex : 999!9999', 
 Cabin STRING COMMENT 'Z99_Z99_Z99_Z99', 
 Embarked STRING COMMENT 'regex : Z'
)
ROW FORMAT SERDE 'com.bizo.hive.serde.csv.CSVSerde'
with serdeproperties (
 "separatorChar" = ",",
 "quoteChar" = "\"",
 "escapeChar" = "\"
 ) 
STORED AS TEXTFILE;
LOAD DATA LOCAL INPATH 'train.csv' INTO TABLE train_tmp;
DROP TABLE IF EXISTS train;
CREATE TABLE train STORED AS ORC AS SELECT * FROM train_tmp;
USE kaggle_titanic;
DROP TABLE IF EXISTS test_tmp;
ADD JAR csv-serde-1.1.2-0.11.0-all.jar;
CREATE TABLE test_tmp (
 PassengerId DOUBLE COMMENT 'regex : 999', 
 Pclass INT COMMENT 'regex : 9', 
 Name STRING COMMENT 'regex : _Zzz!_Zzzzz_!Zzzzzzzzz_!!Zzzzzz!!_Zzzzzz_Zzzzz!!', 
 Sex STRING COMMENT 'regex : zzzzzz', 
 Age DOUBLE COMMENT 'regex : 99!9', 
 SibSp DOUBLE COMMENT 'regex : 9', 
 Parch DOUBLE COMMENT 'regex : 9', 
 Ticket STRING COMMENT 'regex : ZZZZZ!Z!Z!_9999999', 
 Fare DOUBLE COMMENT 'regex : 999!9999', 
 Cabin STRING COMMENT 'Z99_Z99_Z99_Z99', 
 Embarked STRING COMMENT 'regex : Z'
)
ROW FORMAT SERDE 'com.bizo.hive.serde.csv.CSVSerde'
with serdeproperties (
 "separatorChar" = ",",
 "quoteChar" = "\"",
 "escapeChar" = "\"
 ) 
STORED AS TEXTFILE;
LOAD DATA LOCAL INPATH 'test.csv' INTO TABLE test_tmp;
DROP TABLE IF EXISTS test;
CREATE TABLE test STORED AS ORC AS SELECT * FROM test_tmp;
USE kaggle_titanic;
DROP TABLE IF EXISTS train_and_test;
CREATE TABLE train_and_test STORED AS ORC AS 
SELECT CAST(PassengerId AS INT) AS PassengerId, Survived , CAST(Pclass AS INT) , Name, Sex, CAST(Age AS DOUBLE) AS Age, CAST(SibSp AS INT) AS SibSp, CAST(Parch AS INT) AS Parch, Ticket , CAST(Fare AS DOUBLE) AS Fare , Cabin , Embarked 
FROM train
UNION ALL
SELECT CAST(PassengerId AS INT) AS PassengerId, CAST(NULL AS Double) AS Survived , CAST(Pclass AS INT) , Name, Sex, CAST(Age AS DOUBLE) AS Age , CAST(SibSp AS INT) AS SibSp, CAST(Parch AS INT) AS Parch, Ticket , CAST(Fare AS DOUBLE) AS Fare , Cabin , Embarked 
FROM test
;
USE kaggle_titanic;
DROP TABLE IF EXISTS train_and_test;
CREATE TABLE train_and_test STORED AS ORC AS
SELECT PassengerId , Survived , Pclass , Name, Sex, Age , SibSp , Parch  , Ticket , Fare , Cabin , Embarked
FROM train
UNION ALL
SELECT PassengerId , CAST(NULL AS Double) AS Survived , Pclass , Name, Sex, Age , SibSp , Parch  , Ticket , Fare , Cabin , Embarked
FROM test
;

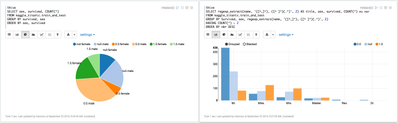
With some quick SQL queries we can already get some good overview of the data, make sure your zeppelin is configured (as well as security)

7921-screenshot-2016-09-23-092715.png

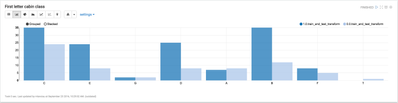
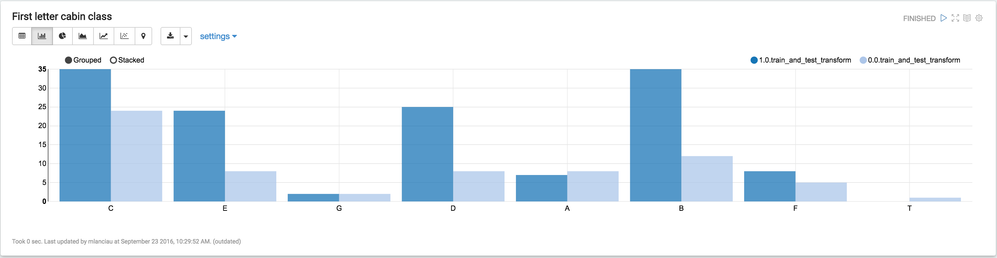
7927-screenshot-2016-09-23-103014.png

Let's now clean the dataset :

USE kaggle_titanic;
DROP TABLE IF EXISTS train_and_test_transform;
CREATE TABLE train_and_test_transform STORED AS ORC AS 
SELECT PassengerId , Survived , Pclass , Name, regexp_extract(name, '([^,]*), ([^ ]*)(.*)', 2) AS title, Sex, CASE WHEN age IS NULL THEN 30 ELSE age END AS age , 
SibSp , Parch  , Ticket , Fare , Cabin , COALESCE(embarked, 'embarked_is_NULL') AS embarked, substring(cabin,1,1) AS cabin_letter, LENGTH(regexp_replace(cabin, '[^ ]', '')) AS nbr_of_space_cabin,
CASE WHEN age IS NULL THEN true ELSE false END AS c_flag_age_null,
CASE WHEN Cabin IS NULL THEN true ELSE false END AS c_flag_cabin_null, 
CASE WHEN embarked IS NULL THEN true ELSE false END AS c_flag_embarked_null
FROM train_and_test
;

----------------------------------------------------------------------------------------------------

(I will update this very soon)

And switch to spark-shell !

import org.apache.spark.ml.feature.{StringIndexer, IndexToString, VectorIndexer, VectorAssembler}
import org.apache.spark.ml.classification.GBTClassificationModel;
import org.apache.spark.ml.classification.GBTClassifier;
val data_prep_1 = sqlContext.sql("SELECT * FROM kaggle_titanic.train_and_test_transform");
data_prep_1.show(10);

Let's do the data transformation and prepare the feature column

val indexerSex = new StringIndexer().setInputCol("sex").setOutputCol("sexIndexed")
val indexerTitle = new StringIndexer().setInputCol("title").setOutputCol("titleIndexed")
val indexerEmbarked = new StringIndexer().setInputCol("embarked").setOutputCol("embarkedIndexed")
val data_prep_2 = indexerSex.fit(data_prep_1).transform(data_prep_1)
val data_prep_3 = indexerTitle.fit(data_prep_2).transform(data_prep_2)
val data_prep_4 = indexerEmbarked.fit(data_prep_3).transform(data_prep_3)
val vectorAssembler = new VectorAssembler().setInputCols(Array("sexIndexed", "titleIndexed", "embarkedIndexed", "age", "fare", "pclass", "parch", "sibsp", "c_flag_cabin_null", "c_flag_null_embarked")).setOutputCol("features")
val data_prep_5 = vectorAssembler.transform(data_prep_4)
data_prep_5.show()
val data_prep_6 = data_prep_5.filter($"survived".isNotNull)
val indexerSurvived = new StringIndexer().setInputCol("survived").setOutputCol("survivedIndexed")
val data_prep_7 = indexerSurvived.fit(data_prep_6).transform(data_prep_6)

And now let's build the model

val gbt = new GBTClassifier().setLabelCol("survivedIndexed").setFeaturesCol("features").setMaxIter(50)
var model = gbt.fit(data_prep_7)

Finally we can gather the data to predict and use the model :

val data_test_1 = data_prep_5.filter($"survived".isNull)
var result = model.transform(data_test_1)
result.select("passengerid", "prediction").show(1000)

screenshot-2016-09-23-103014.png
2,234 Views
Version history
Last update:
‎08-17-2019 10:04 AM
Updated by:
Contributors